Doubao Seed 2.1 API を Tokuse で利用する:Pro / Lite / Turbo の料金・品質・選び方
Tokuse は ByteDance の Doubao Seed 2.1 シリーズに含まれる 3 モデルを、OpenAI 互換の単一エンドポイントで利用できるようにしました。同じ API 形式のまま、Pro / Lite / Turbo という 3 つの価格帯を選べる点が実務上のポイントです。
本記事では 2026 年 11 月 16 日時点の Tokuse モデルカタログをもとに、各モデルの位置づけ、実際のコスト、OpenAI SDK と Anthropic SDK からの呼び出し方、DeepSeek との使い分けを整理します。
料金は変更される可能性があります。予算を確定する前に Tokuse の料金ページ で最新価格を確認してください。
結論
| モデル ID | 入力 / 100万トークン | 出力 / 100万トークン | プロトコル | 主な用途 |
|---|---|---|---|---|
doubao-seed-2-1-pro-260915 |
$0.8220 | $4.1100 | OpenAI、Anthropic | 難しい推論、長文分析、品質優先のエージェント処理 |
doubao-seed-2-1-lite-260915 |
$0.1096 | $0.3699 | OpenAI、Anthropic | 日常的なチャット、要約、抽出、分類、高トラフィック処理 |
doubao-seed-2-1-turbo-260628 |
$0.0876 | $2.1900 | OpenAI、Anthropic | 超長入力・超短出力で、出力トークンを厳しく制限できる処理 |
重要なのは次の 2 点です。
- Lite はバランス型ワークロードのコスト下限です。現在の Tokuse 価格では、入力・出力ともに DeepSeek Flash より約 60% / 66% 安くなります。
- Turbo は「安い Lite」ではありません。 入力単価は最も低い一方、出力単価は Lite の約 5.9 倍です。入力が長く、出力が非常に短い処理だけに向きます。
Pro は品質優先のモデルです。全リクエストを Pro にするのではなく、Lite で品質基準を満たせない処理だけを Pro に回すのが基本です。
各モデルの特徴
Doubao Seed 2.1 Pro はこのシリーズの最上位モデルです。多段階の計画、ツール呼び出し、長い文書の分析、指示追従が重要な回答に向きます。出力単価が最も高いため、「誤答のコストがトークン代より高い」処理に限定するのが現実的です。
Doubao Seed 2.1 Lite はバランス型で、最初の選択肢として最も使いやすいモデルです。カスタマーサポート、要約、構造化抽出、タグ付け、分類、通常のエージェント処理を Lite で開始し、必要な処理だけ昇格させます。
Doubao Seed 2.1 Turbo は入力が重く、出力が軽い処理向けです。長いコンテキストを読み、ラベルや JSON、ルーティング結果だけを返すようなユースケースが該当します。長文生成に使うと、出力単価 $2.1900 がすぐに効いてきます。
実際のコスト例
単価だけを見ると判断を誤ります。出力の比率が変わると、順位も変わります。
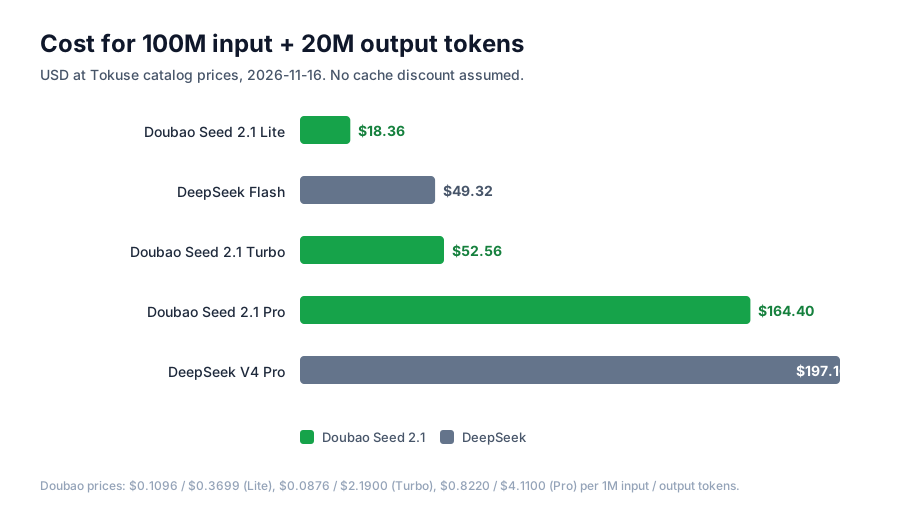
1 億入力トークン + 2,000 万出力トークンの例です。
| モデル | 入力コスト | 出力コスト | 合計 |
|---|---|---|---|
| Doubao Seed 2.1 Lite | $10.96 | $7.40 | $18.36 |
| DeepSeek Flash | $27.40 | $21.92 | $49.32 |
| Doubao Seed 2.1 Turbo | $8.76 | $43.80 | $52.56 |
| Doubao Seed 2.1 Pro | $82.20 | $82.20 | $164.40 |
| DeepSeek V4 Pro | $123.20 | $73.96 | $197.16 |
この入力・出力比率では、Lite は DeepSeek Flash より約 63% 安くなります。Turbo は出力単価の高さで DeepSeek Flash をわずかに上回ります。Pro は DeepSeek V4 Pro に近い水準で、品質優先モデルとして妥当な価格帯です。
ワークロードを変えると順位も変わります。
| ワークロード | Doubao Lite | Doubao Turbo | DeepSeek Flash |
|---|---|---|---|
| 8,000万入力 + 400万出力 | $10.25 | $15.77 | $26.30 |
| 1,000万入力 + 5,000万出力 | $19.59 | $110.38 | $57.54 |
長文レポート、コード生成、会話のように出力が多い処理では、Lite が最も安いままです。Turbo が有利になるのは、出力が入力に対してごく小さい場合だけです。
キャッシュ価格の注意点
DeepSeek にはキャッシュヒット価格があり、Tokuse のカタログにも倍率が表示されています。現在の deepseek-flash では、キャッシュヒット時の入力は 100 万トークンあたり約 $0.006 です。
Doubao Seed 2.1 の Tokuse 価格はキャッシュ割引を前提としていません。同じ長いシステムプロンプトやエージェント文脈を繰り返す処理では、キャッシュヒット率を先に見積もってください。出力が小さい処理では、高いキャッシュヒット率の DeepSeek Flash が Lite を逆転する可能性があります。出力が多い処理では、Lite の低い出力単価が引き続き支配的です。
単一の単価ではなく、コスト計算機 と Tokuse の利用ログで確認することをおすすめします。
OpenAI SDK で呼び出す
3 モデルとも https://tokuse.com/v1 の OpenAI 互換 Chat Completions を受け付けます。既存の SDK を使い、base URL とモデル ID だけを変更します。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["TOKUSE_API_KEY"],
    base_url="https://tokuse.com/v1",
)

response = client.chat.completions.create(
    model="doubao-seed-2-1-lite-260915",
    messages=[
        {"role": "system", "content": "顧客の意図を JSON で抽出してください。"},
        {"role": "user", "content": "二重に請求されました。返金をお願いします。"},
    ],
)

print(response.choices[0].message.content)
Node.js でも同じです。
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.TOKUSE_API_KEY,
  baseURL: "https://tokuse.com/v1",
});

const response = await client.chat.completions.create({
  model: "doubao-seed-2-1-pro-260915",
  messages: [{ role: "user", content: "この契約書を要約してください。" }],
});
curl の場合:
curl https://tokuse.com/v1/chat/completions \
  -H "Authorization: Bearer $TOKUSE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "doubao-seed-2-1-turbo-260628",
    "messages": [{"role": "user", "content": "分類: 返金リクエスト"}],
    "temperature": 0
  }'
Anthropic Messages プロトコルも利用可能
Doubao Seed 2.1 は Tokuse 上で Anthropic Messages 形式にも対応しています。base URL を https://tokuse.com に設定します。
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["TOKUSE_API_KEY"],
    base_url="https://tokuse.com",
)

message = client.messages.create(
    model="doubao-seed-2-1-pro-260915",
    max_tokens=1024,
    messages=[{"role": "user", "content": "3 段階の移行計画を立案してください。"}],
)

print(message.content[0].text)
すでに Anthropic 互換クライアントを利用している場合は、新しい SDK を追加せずに Doubao を試せます。詳細は Anthropic Messages ガイド を参照してください。
ストリーミングとエラー処理
ストリーミングは他の OpenAI 互換モデルと同じです。
stream = client.chat.completions.create(
    model="doubao-seed-2-1-lite-260915",
    messages=[{"role": "user", "content": "短い製品アップデートを書いてください。"}],
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta.content
    if delta:
        print(delta, end="")
注意すべきエラー:
- 401: API キーの欠落、末尾の空白、base URL の誤り。
- 404: モデル ID またはパスの誤り。Doubao の ID は
260915のような日付サフィックスを含みます。カタログから完全な ID をコピーしてください。 - 429: レートまたはクォータ制限。上限付きの指数バックオフとジッターを使います。
- タイムアウト: 長い生成で発生します。想定 p95 より長いクライアントタイムアウトを設定し、タイムアウトを「結果不明」として扱います。
本番環境での選び方
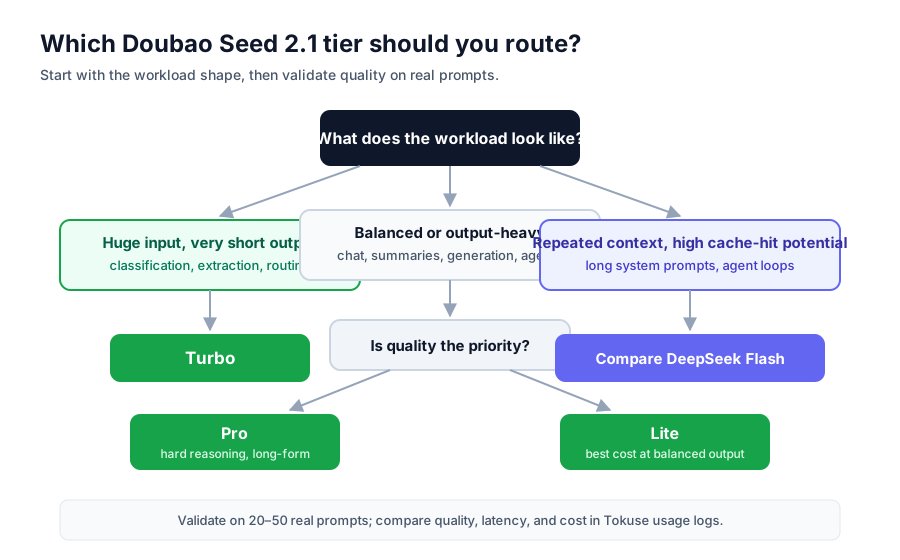
- まず Lite をデフォルトにする。 バランス型・出力重視の処理で最も安くなります。
- Pro への昇格はタスク単位で行う。 20〜50 件の実プロンプトで評価し、Lite が基準を満たさない意図だけを Pro に回します。
- Turbo は出力長を厳密に制限できる処理だけに使う。 分類、抽出、ルーティング、検索後の一言回答などです。
- 文脈が繰り返される場合は DeepSeek と比較する。 キャッシュヒット率が高い場合は、有効入力コストを計算してから切り替えます。
- モデルと意図ごとに利用量を記録する。 Tokuse の利用ログで、どのモデルがコストに見合うかを確認します。
品質評価も同じ方法で行います。同じプロンプト群を Lite、Pro、Turbo で実行し、出力を保存して自社の基準で採点します。公開ベンチマークの代わりにはなりません。
本番前チェックリスト
- モデル ID が自分の Tokuse グループで利用可能か確認する。
- モデル ID を設定に固定する。実行時に変わるエイリアスに依存しない。
- クライアントのタイムアウトを想定生成時間より長くする。
- リトライは上限付きで、ジッターを入れる。
- モデル、意図、コストセンター単位で利用量を記録する。
- JSON コードブロックとストリーミングの部分チャンクを正しくパースする。
- 429 と 5xx 用にフォールバックモデルを用意する。
FAQ
Doubao Seed 2.1 は Tokuse で OpenAI 互換ですか?
はい。https://tokuse.com/v1 と OpenAI Chat Completions 形式を使い、モデル ID に Doubao の完全な ID を指定します。
OpenAI / Anthropic SDK をそのまま使えますか? 使えます。base URL とモデル ID を変更するだけで、リクエスト形式は同じです。
どのモデルが最も安いですか? バランス型・出力重視の処理では Lite が最も安くなります。入力が非常に長く出力が短い場合だけ Turbo が有利です。最新価格は Tokuse 料金ページ を確認してください。
Doubao と DeepSeek を切り替えるには?
同じゲートウェイなので、model フィールドを変更するだけです。エンドポイントや SDK の変更は不要です。
Continue、Cline、Cursor、LangChain で使えますか? OpenAI 互換の base URL を設定できるクライアントなら利用できます。主なツールは 連携ガイド にまとめています。
自分のプロンプトで 3 モデルを試す
本当に意味のある比較は、単価ではなく、自分のアプリケーションが実際に送るプロンプトでの品質とコストです。
Tokuse アカウントを作成し、まず Lite をデフォルトにしてください。品質が足りない処理だけを Pro に昇格させます。開始はこちら: tokuse.com/register。