豆包 Seed 2.1 API 接入 Tokuse:Pro / Lite / Turbo 价格、效果与选型指南
Tokuse 已经接入 ByteDance 豆包 Seed 2.1 系列的三个模型,并且统一提供 OpenAI 兼容接口。对正在控制 AI 成本的团队来说,这不是多了一个模型选项,而是多了一组价格梯度:同样一套代码,可以在 Pro、Lite、Turbo 之间按任务切换,把能力档位和成本档位分开管理。
本文基于 2026 年 11 月 16 日 Tokuse 线上模型目录,对比 doubao-seed-2-1-pro-260915、doubao-seed-2-1-lite-260915、doubao-seed-2-1-turbo-260628 的价格、适用场景和接入方式。所有价格以 Tokuse 定价页 的实时数据为准,采购前请重新核对。
一句话结论
| 模型 ID | 输入 / 百万 Token | 输出 / 百万 Token | 协议 | 适合场景 |
|---|---|---|---|---|
doubao-seed-2-1-pro-260915 |
$0.8220 | $4.1100 | OpenAI、Anthropic | 复杂推理、长文分析、质量优先的 Agent 步骤 |
doubao-seed-2-1-lite-260915 |
$0.1096 | $0.3699 | OpenAI、Anthropic | 日常对话、摘要、抽取、分类、高并发自动化 |
doubao-seed-2-1-turbo-260628 |
$0.0876 | $2.1900 | OpenAI、Anthropic | 超长输入、极短输出,输出 Token 必须严格受控 |
两个关键差异:
- Lite 是平衡型工作负载的成本底线。 在当前 Tokuse 价格下,它的输入和输出单价都比 DeepSeek Flash 低约 60% 和 66%。
- Turbo 不是"更便宜的 Lite"。 它的输入单价最低,但输出单价约为 Lite 的 5.9 倍。只有输入很长、输出很短的任务才适合 Turbo。
Pro 是能力档,不是默认档。它适合 Lite 达不到质量线的那部分任务,而不是所有请求都走 Pro。
三个模型分别适合什么
豆包 Seed 2.1 的三个档位是按工作负载形态划分的,不是按一个跑分排序。
豆包 Seed 2.1 Pro 是这一系列的能力档。多步规划、工具调用、长文档分析、对指令遵循要求高的回答,应该优先在 Pro 上验证。它的输出价格是三档中最高的,所以适合"答错比 Token 更贵"的任务。
豆包 Seed 2.1 Lite 是平衡档,也是最值得作为默认选项的模型。客服、摘要、结构化抽取、打标签、分类、常规 Agent 步骤都可以先跑 Lite。$0.1096 的输入价和 $0.3699 的输出价,让高请求量场景的成本更可控。
豆包 Seed 2.1 Turbo 面向输入重、输出轻的任务。例如读取很长的上下文,最后只返回一个标签、一个 JSON、一条路由判断。它的输入价 $0.0876 是三档最低,但一旦生成长答案,$2.1900 的输出价会迅速放大账单。
实际策略可以很简单:默认 Lite,用真实提示词做评测;达不到质量线的意图升级到 Pro;只有输出长度确实受控的任务才用 Turbo。
一个真实工作负载的成本
只看单价容易误判。输出占比一高,账单结构就会变。
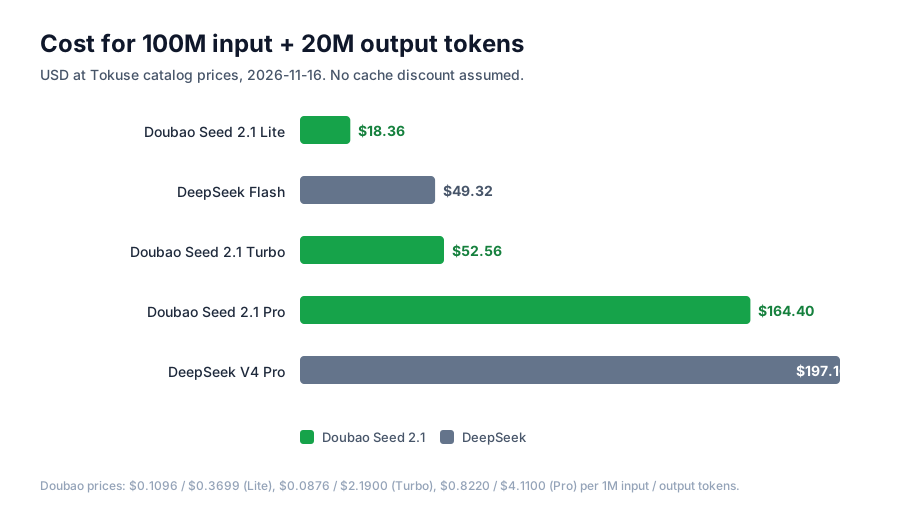
以 1 亿输入 Token + 2000 万输出 Token 为例,把豆包 Seed 2.1 和 Tokuse 上的两个 DeepSeek 模型放在一起比较:
| 模型 | 输入成本 | 输出成本 | 合计 |
|---|---|---|---|
| 豆包 Seed 2.1 Lite | $10.96 | $7.40 | $18.36 |
| DeepSeek Flash | $27.40 | $21.92 | $49.32 |
| 豆包 Seed 2.1 Turbo | $8.76 | $43.80 | $52.56 |
| 豆包 Seed 2.1 Pro | $82.20 | $82.20 | $164.40 |
| DeepSeek V4 Pro | $123.20 | $73.96 | $197.16 |
在这个输入输出比例下,Lite 比 DeepSeek Flash 便宜约 63%。Turbo 因为输出单价高,反而略贵于 DeepSeek Flash。Pro 的成本接近 DeepSeek V4 Pro,符合能力档的定位。
换一个工作负载,排序会变:
| 工作负载 | 豆包 Lite | 豆包 Turbo | DeepSeek Flash |
|---|---|---|---|
| 8000 万输入 + 400 万输出 | $10.25 | $15.77 | $26.30 |
| 1000 万输入 + 5000 万输出 | $19.59 | $110.38 | $57.54 |
长报告、代码生成、多轮对话这类输出偏重的工作,Lite 仍然是这组里最便宜的。Turbo 只有在输出占输入比例极低时才有优势。
缓存价格不能忽略
DeepSeek 提供缓存命中价格,Tokuse 的模型目录也暴露了对应的缓存倍率。按当前 deepseek-flash 价格,缓存命中输入约为每百万 Token $0.006,远低于未命中的 $0.274。
豆包 Seed 2.1 在 Tokuse 目录中的报价不包含缓存折扣假设。如果你的应用会反复复用同一段长系统提示词或 Agent 上下文,先测算缓存命中比例,再判断 Lite 是否一定更便宜。对于输出很小的任务,高缓存命中率的 DeepSeek Flash 有可能在总成本上反超 Lite;对于输出很重的工作,Lite 的低输出价仍然是决定因素。
这也是为什么应该用 成本计算器 和 Tokuse 的用量日志来验证,而不是只看一个首页单价。
用 OpenAI SDK 调用豆包 Seed 2.1
三个模型都接受 https://tokuse.com/v1 的 OpenAI 兼容 Chat Completions 请求。保留现有 SDK,只改 base URL 和模型 ID。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["TOKUSE_API_KEY"],
    base_url="https://tokuse.com/v1",
)

response = client.chat.completions.create(
    model="doubao-seed-2-1-lite-260915",
    messages=[
        {"role": "system", "content": "把客户意图抽取为 JSON。"},
        {"role": "user", "content": "我被重复扣费了,需要退款。"},
    ],
)

print(response.choices[0].message.content)
Node.js 的写法相同:
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.TOKUSE_API_KEY,
  baseURL: "https://tokuse.com/v1",
});

const response = await client.chat.completions.create({
  model: "doubao-seed-2-1-pro-260915",
  messages: [{ role: "user", content: "总结这份合同。" }],
});
也可以直接发 HTTP 请求:
curl https://tokuse.com/v1/chat/completions \
  -H "Authorization: Bearer $TOKUSE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "doubao-seed-2-1-turbo-260628",
    "messages": [{"role": "user", "content": "分类:退款请求"}],
    "temperature": 0
  }'
也可以使用 Anthropic Messages 协议
豆包 Seed 2.1 在 Tokuse 上同时支持 Anthropic Messages 格式。把 base URL 设为 https://tokuse.com,路径由 SDK 处理:
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["TOKUSE_API_KEY"],
    base_url="https://tokuse.com",
)

message = client.messages.create(
    model="doubao-seed-2-1-pro-260915",
    max_tokens=1024,
    messages=[{"role": "user", "content": "规划一个三步迁移方案。"}],
)

print(message.content[0].text)
如果现有系统已经用 Anthropic 兼容客户端跑 Claude,这条路可以让你不引入第二个 SDK 就完成豆包测试。完整的协议说明见 Anthropic Messages 指南。
流式、超时和常见错误
流式调用和其他 OpenAI 兼容模型一致:
stream = client.chat.completions.create(
    model="doubao-seed-2-1-lite-260915",
    messages=[{"role": "user", "content": "写一段简短的产品更新。"}],
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta.content
    if delta:
        print(delta, end="")
几个错误值得单独处理:
- 401:通常是 Key 缺失、Key 末尾带空格,或者 base URL 写错。
- 404:通常是模型 ID 或路径错误。豆包模型 ID 带日期后缀(例如
260915),请从 Tokuse 模型目录复制完整 ID,不要自己拼接。 - 429:触发速率或额度限制。使用有上限的指数退避加随机抖动,不要无限重试。
- 超时:长文本生成可能超时。客户端超时应高于预期的 p95 延迟,并且把超时当作"结果未知"处理,而不是直接判定生成失败。
更完整的请求格式见 Chat Completions 参考。
生产环境怎么选型
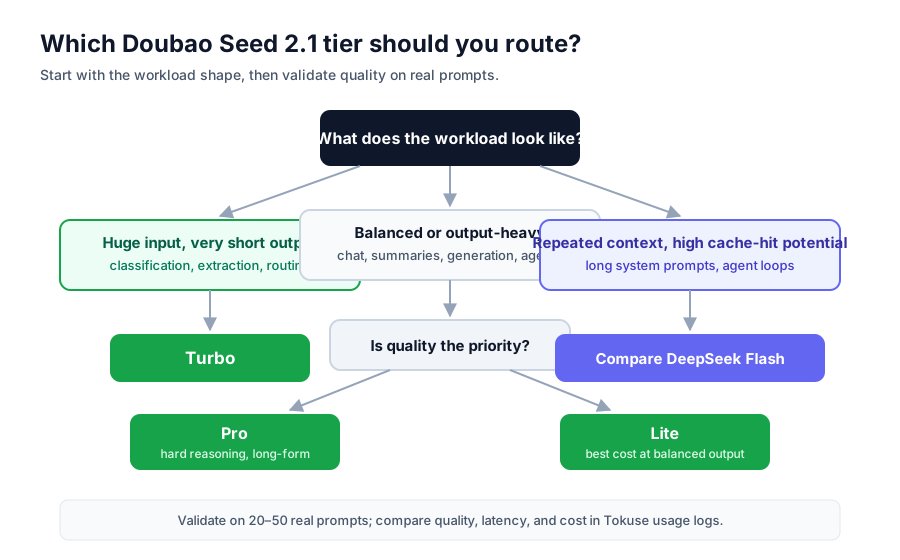
对大多数团队,下面这套路由策略已经够用:
- 默认 Lite。 它是平衡型和输出偏重型流量的成本底线。
- 按任务升级 Pro,不按请求量升级。 准备 20–50 条真实提示词做评测;只有某个意图在 Lite 上不达标,才把这个意图路由到 Pro。
- 输出严格受限时用 Turbo。 分类、抽取、路由、检索后一句话回答适合 Turbo;长对话不合适。
- 上下文重复时对比 DeepSeek。 如果大部分输入 Token 都能命中缓存,先测算有效输入成本再切换。
- 按模型和意图记录用量。 Tokuse 的用量日志能看出哪个档位真正值这个价,而不是靠单价猜。
评估效果也可以沿用同一套方法:把同一组提示词分别跑 Lite、Pro、Turbo,保留输出,用你自己的标准打分。没有任何公开跑分能替代这一步。
上线前检查清单
- 确认模型 ID 对你的 Tokuse 分组可用。豆包模型按分组开放,目录里能看到对应分组。
- 模型 ID 固定在配置里,不要在运行时依赖会变化的别名。
- 客户端超时高于预期生成时间。
- 重试有上限,并带随机抖动。
- 按模型、意图、成本中心记录用量。
- 输出解析能处理 JSON 代码块和流式分片。
- 为 429 和 5xx 配置降级模型。
常见问题
豆包 Seed 2.1 在 Tokuse 上兼容 OpenAI 吗?
兼容。使用 https://tokuse.com/v1 和 OpenAI Chat Completions 请求格式,模型 ID 填豆包的完整 ID。
可以继续用 OpenAI 或 Anthropic SDK 吗? 可以。改 base URL 和模型 ID 即可,请求结构不变。豆包模型在 Tokuse 上同时支持两种协议。
哪个档位最便宜? 平衡型和输出偏重型工作负载用 Lite 最便宜。只有输入很长、输出极短时,Turbo 才更便宜。实时价格见 Tokuse 定价页。
豆包和 DeepSeek 之间怎么切换?
两者走同一个网关。只改 model 字段,不需要换端点或 SDK。
怎么先估算成本? 用免费的 成本计算器,再到 Tokuse 定价页 核对模型 ID 和实时单价。
Continue、Cline、Cursor、LangChain 能用吗? 可以。任何支持 OpenAI 兼容 base URL 的客户端都能指向 Tokuse,常见工具见 接入指南。
用你自己的提示词测试三个档位
真正有价值的对比不是单价,而是你的应用在自己的提示词上得到的质量和成本。
创建 Tokuse 账号,先把 Lite 设为默认,只把需要 Pro 的意图升级上去。入口在这里:tokuse.com/register。